Por qué la IA se inventa cosas (y no es un fallo técnico cualquiera)
Le preguntas a ChatGPT una fecha, un dato o una cita, y te la da con total seguridad. Suena bien, está bien redactada… y es falsa. Esto se llama alucinación, y durante años se ha explicado como “un fallo técnico que se irá puliendo”. En septiembre de 2025, un estudio de OpenAI dio una explicación distinta y bastante más incómoda: los modelos alucinan porque así es como les hemos enseñado a aprobar el examen.
Revisado en septiembre de 2026.
Qué es exactamente una alucinación
Una alucinación es una afirmación falsa pero presentada como cierta, con el mismo tono seguro que usaría el modelo para algo verdadero. No hay diferencia de “estilo” entre un dato real y uno inventado: el modelo no tiene una alarma interna que se encienda cuando no sabe algo. Genera la secuencia de palabras estadísticamente más probable, y a veces esa secuencia es incorrecta.
El ejemplo que pusieron los propios investigadores de OpenAI es revelador: le preguntaron a un chatbot varias veces por el título de la tesis doctoral y la fecha de nacimiento de uno de los autores del estudio, Adam Tauman Kalai. El modelo respondió con seguridad total. Las tres respuestas eran incorrectas.
La explicación: es un problema de cómo se examina a la IA
El estudio (“Why Language Models Hallucinate”, Kalai, Nachum, Vempala y Zhang, OpenAI, 2025) compara el entrenamiento de un modelo con presentarse a un examen tipo test:
- Si adivinas, puede que aciertes.
- Si dejas la pregunta en blanco, tienes la seguridad de sacar un cero.
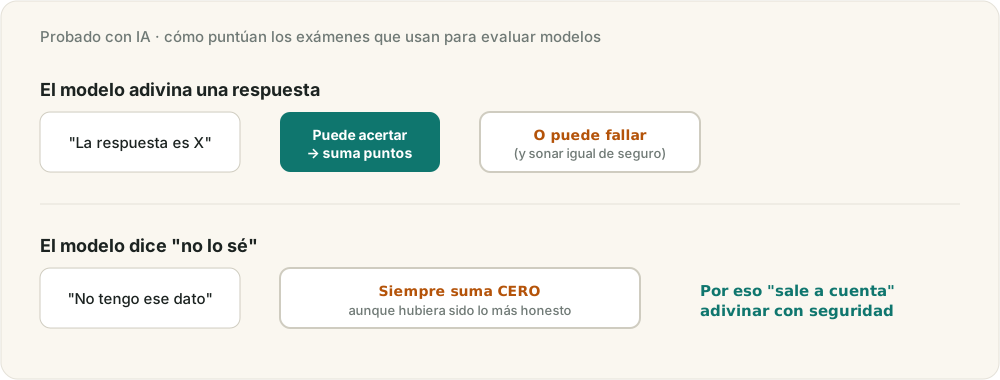
Bajo esas reglas, adivinar siempre compensa más que abstenerse, aunque no estés seguro. Los exámenes con los que se evalúa a los modelos de IA (los “benchmarks” que deciden qué modelo es mejor) funcionan igual: puntúan solo por acierto. Un modelo que dice “no lo sé” saca cero en esa pregunta; un modelo que se inventa una respuesta con seguridad tiene una posibilidad de acertar y sumar.
Cuando a los modelos se les puntúa solo por precisión —el porcentaje de preguntas que aciertan exactamente—, se les está empujando a adivinar en vez de admitir que no saben algo.
El resultado, dicen los autores, es que mientras los principales marcadores sigan premiando la suerte, los modelos seguirán aprendiendo a adivinar. No es un error que se arregle con una actualización: es la consecuencia directa de cómo se mide el “éxito” de un modelo.
Por qué pasa más con ciertos datos
Hay una segunda causa, más técnica: un modelo aprende patrones del lenguaje viendo textos una y otra vez. Con hechos que aparecen muchas veces en sus datos de entrenamiento (capitales, fechas históricas conocidas, personajes famosos), el patrón es fuerte y el modelo acierta casi siempre. Con datos que aparecen una sola vez o muy pocas —como la tesis doctoral de una persona concreta, un dato muy específico de una empresa pequeña, una cifra de un informe poco citado—, no hay patrón claro que seguir. Ahí el modelo no tiene forma de “saber” que no sabe, y genera la respuesta más plausible según lo poco que ha visto. Eso explica por qué las alucinaciones son más frecuentes con nombres propios poco conocidos, cifras exactas, citas textuales y datos muy recientes.
La solución que proponen (y por qué todavía no está aquí)
Los propios autores proponen cambiar cómo se evalúan los modelos: penalizar más un error dicho con seguridad que decir “no lo sé”, y dar crédito parcial por expresar incertidumbre correctamente — como en un examen que resta por fallo. Con ese cambio de incentivos, entrenar a un modelo para que sea honesto sobre lo que no sabe dejaría de ser un sacrificio de puntuación.
El problema es que esto requiere cambiar los benchmarks que usa todo el sector para comparar modelos, no solo el entrenamiento de una empresa. Mientras eso no ocurra de forma generalizada, el incentivo a adivinar sigue ahí.
Qué puedes hacer tú, mientras tanto
- Usa herramientas ancladas a una fuente para lo importante: Gemini Notebook (antes NotebookLM) solo responde con el documento que le das y puede citar la página, así que reduce mucho el riesgo frente a un asistente general que “sabe de todo”.
- Pide que cite la fuente de cualquier dato concreto: “dame el enlace de donde sacas esa cifra”. Si no puede, sospecha.
- Desconfía más cuanto más específico sea el dato: una fecha exacta, una cita textual, una cifra con decimales o un nombre poco conocido son las zonas de mayor riesgo.
- Pídele explícitamente que dude: un prompt como “si no estás seguro de un dato, dilo en vez de inventarlo” ayuda, aunque no elimina el problema del todo (el modelo sigue entrenado para sonar seguro).
- Verifica tú lo que vayas a usar de verdad: en un trabajo, un informe o una decisión, contrasta cualquier dato concreto con una fuente real antes de darlo por bueno.
Por qué la responsabilidad sigue siendo tuya
La IA no se inventa datos por un fallo puntual: lo hace porque el sistema con el que se entrena y se evalúa premia adivinar con seguridad antes que admitir que no sabe algo, igual que en un examen tipo test donde dejar la respuesta en blanco garantiza un cero. Hasta que ese incentivo cambie de forma generalizada en el sector, la responsabilidad de verificar los datos importantes sigue siendo tuya.
Preguntas frecuentes
¿Qué es una alucinación de la IA?
Es cuando un modelo de IA da una respuesta falsa con la misma seguridad y el mismo tono que si fuera cierta. No es que 'mienta' a propósito: genera la respuesta más probable según su entrenamiento, y a veces lo más probable es incorrecto.
¿Por qué OpenAI dice que la IA prefiere inventar antes que decir 'no lo sé'?
Porque así es como se la entrena y se la evalúa. En los exámenes tipo test que se usan para medir a los modelos, acertar suma punto y no responder suma cero, igual que en un examen con puntos por respuesta en blanco. Adivinar sale a cuenta, así que los modelos aprenden a adivinar con seguridad en vez de admitir que no saben algo.
¿Se puede eliminar la alucinación por completo?
Con la tecnología actual, no del todo. Se puede reducir mucho: usando herramientas ancladas a una fuente (como Gemini Notebook), pidiendo que cite de dónde saca cada dato, y verificando tú las cifras, fechas y nombres antes de darlas por buenas.
Sigue explorando
Crea en 30 segundos un prompt completo para ChatGPT, Gemini o Claude con nuestro generador gratuito, o sigue leyendo guías probadas.
¿Ves algo desactualizado o un error? Escríbenos a hola@probadoconia.es y lo corregimos.